人形机器人全身控制器对比:为什么选择 ProtoMotions
全身控制选型首先要回答:希望给机器人一条轨迹、一个稀疏目标,还是一个奖励函数?这三种输入对控制器提出的要求不同。演示视频都能让机器人走路、蹲下和挥手,不代表它们内部解决的是同一个问题。
本文把 BeyondMimic 作为动作跟踪基础,把 ProtoMotions 作为可扩展训练框架,再比较 TWIST2、SONIC 和 BFM-Zero。重点是每条路线接收什么条件、优化什么目标、新增机器人需要重做什么,以及这些选择能否支持后续的物体交互与柔顺控制。
1. 先明确比较对象:框架、策略还是集成系统
一个典型系统可以分为任务意图、运动条件、低层反馈策略和执行器四层:
任务意图 可以是“到达那里”或“把手抬高”;条件 可以是完整参考姿态、关键点、latent token; 最终还要经过关节目标和执行器模型。
图 1:按输入与反馈接口分类,不表示性能排名。ProtoMotions 是承载具体策略实验的框架;比较时需要指明其中使用哪种实验配置。
| 路线 | 本文讨论对象 | 主要条件接口 | 需要单独验证的能力 |
|---|---|---|---|
| BeyondMimic | 动作跟踪训练基线 | 当前状态与动作参考 | 新动作覆盖、连续执行与迁移 |
| ProtoMotions | 动作跟踪方案与扩展框架 | 显式动作参考;其他实验可扩展条件 | 每种实验的观测、动作与模型契约 |
| TWIST2 | 全身控制在采集系统中的角色 | 人体运动经处理后的控制参考 | 端到端时延、同步及数据质量 |
| SONIC | 通用动作控制接口 | 多类运动输入编码到共享 token 空间 | 编码覆盖、规划器与低层策略衔接 |
| BFM-Zero | 可提示的行为模型 | 目标、动作或奖励映射到 latent | latent 推断质量与任务分布覆盖 |
框架、训练方法和集成系统处在不同层级,不能把某个系统的整套功能全部归给它的低层 actor。
2. BeyondMimic:先建立一条能解释的反馈链
BeyondMimic 适合先回答一个基本问题:在动作参考已知时,如何让带执行器约束的浮动基座机器人完成跟踪?跟踪奖励、参考初始化、自适应采样、观测和 PD 接口形成一个可以逐项检查的基础。BeyondMimic 实现
用简化目标表示:
轨迹给了策略“接下来该像什么”的密集条件。但如何为新任务产生轨迹,仍需要上层解决。跟踪器可以是通用系统的重要底座,却不能由此推导出它已经理解任意任务奖励。
这里最有价值的基线不是“能播放一个漂亮动作”,而是固定机器人和数据之后,能解释误差来自参考不可行、控制参数、观测缺失还是策略不足。没有这个基线,换成更大模型后即使失败,也很难定位原因。
3. ProtoMotions:为什么值得作为下一阶段的载体
ProtoMotions 将机器人配置、模拟器、动作数据、观测、奖励和策略实验组织为可组合模块。它提供的是迭代控制器的工程基础;具体能力取决于所选实验、数据和训练结果。ProtoMotions 官方仓库
在本文采用的动作跟踪方案中,31 自由度 actor 读取 reduced-coordinate 状态、未来 20–160 ms 的参考和历史关节目标,critic 使用更完整信息;策略动作经显式映射后交给 PD。它已经把研究问题缩小成几个可以控制的变量:
- 动作覆盖扩大后,哪些类别的连续完成率改善?
- 改变参考前瞻窗口,对接触切换和在线指令延迟有什么影响?
- 观测局部一致性正则是否降低机械抖动,又牺牲了多少快速响应?
- 更换模拟器后,哪类接触误差和饱和行为发生变化?
这些问题不要求先构建完整的人体采集系统,也不要求先训练一个任意奖励提示模型。对于已有重定向数据、需要适配特定机器人并继续研究柔顺交互的阶段,显式的动作跟踪链使实验更容易归因。
这个选择有明确代价:数据生成和动作可执行性仍然要自己保证;若上层只给一个稀疏手部目标,还需要目标补全、规划或另一个条件化实验,不能假设当前全参考策略天然支持。
4. TWIST2:系统能力与低层能力分开看
TWIST2 的定位是可扩展、便携的全身遥操作与数据采集系统,并把收集的数据用于后续视觉策略。理解其全身控制能力,需要把低层反馈与采集系统的其他组件分开评价。TWIST2 论文
对这类系统,端到端表现不仅取决于控制误差,还取决于输入估计、时间同步、缓存、网络和执行周期。可以把总时延写成:
这是通用工程分解,并非论文报告的某个时延测量。假设一个 2 Hz 的摆臂信号遇到 80 ms 延迟,纯延迟项产生约 相位滞后。即使静态姿态很准,动态跟随也可能明显落后。
因此系统演示成功率不能直接当作低层跟踪器精度;反过来,只在离线动作上测到小误差,也不能证明遥操作链可用。当前首先解决全身控制器训练与机器人迁移,完整遥操与采集链可以作为后续独立课题。
5. SONIC:把动作跟踪规模化,再统一控制入口
SONIC 强调扩大动作数据、模型容量和训练计算,并将不同运动输入映射到共享控制表示。官方给出的规模包括最高 42M 参数、700 小时动作捕捉数据和 21k GPU 小时;它还展示了通过运动规划器及统一接口连接下游任务的方式。这些是其项目报告,不是本文复现结果。SONIC 项目页
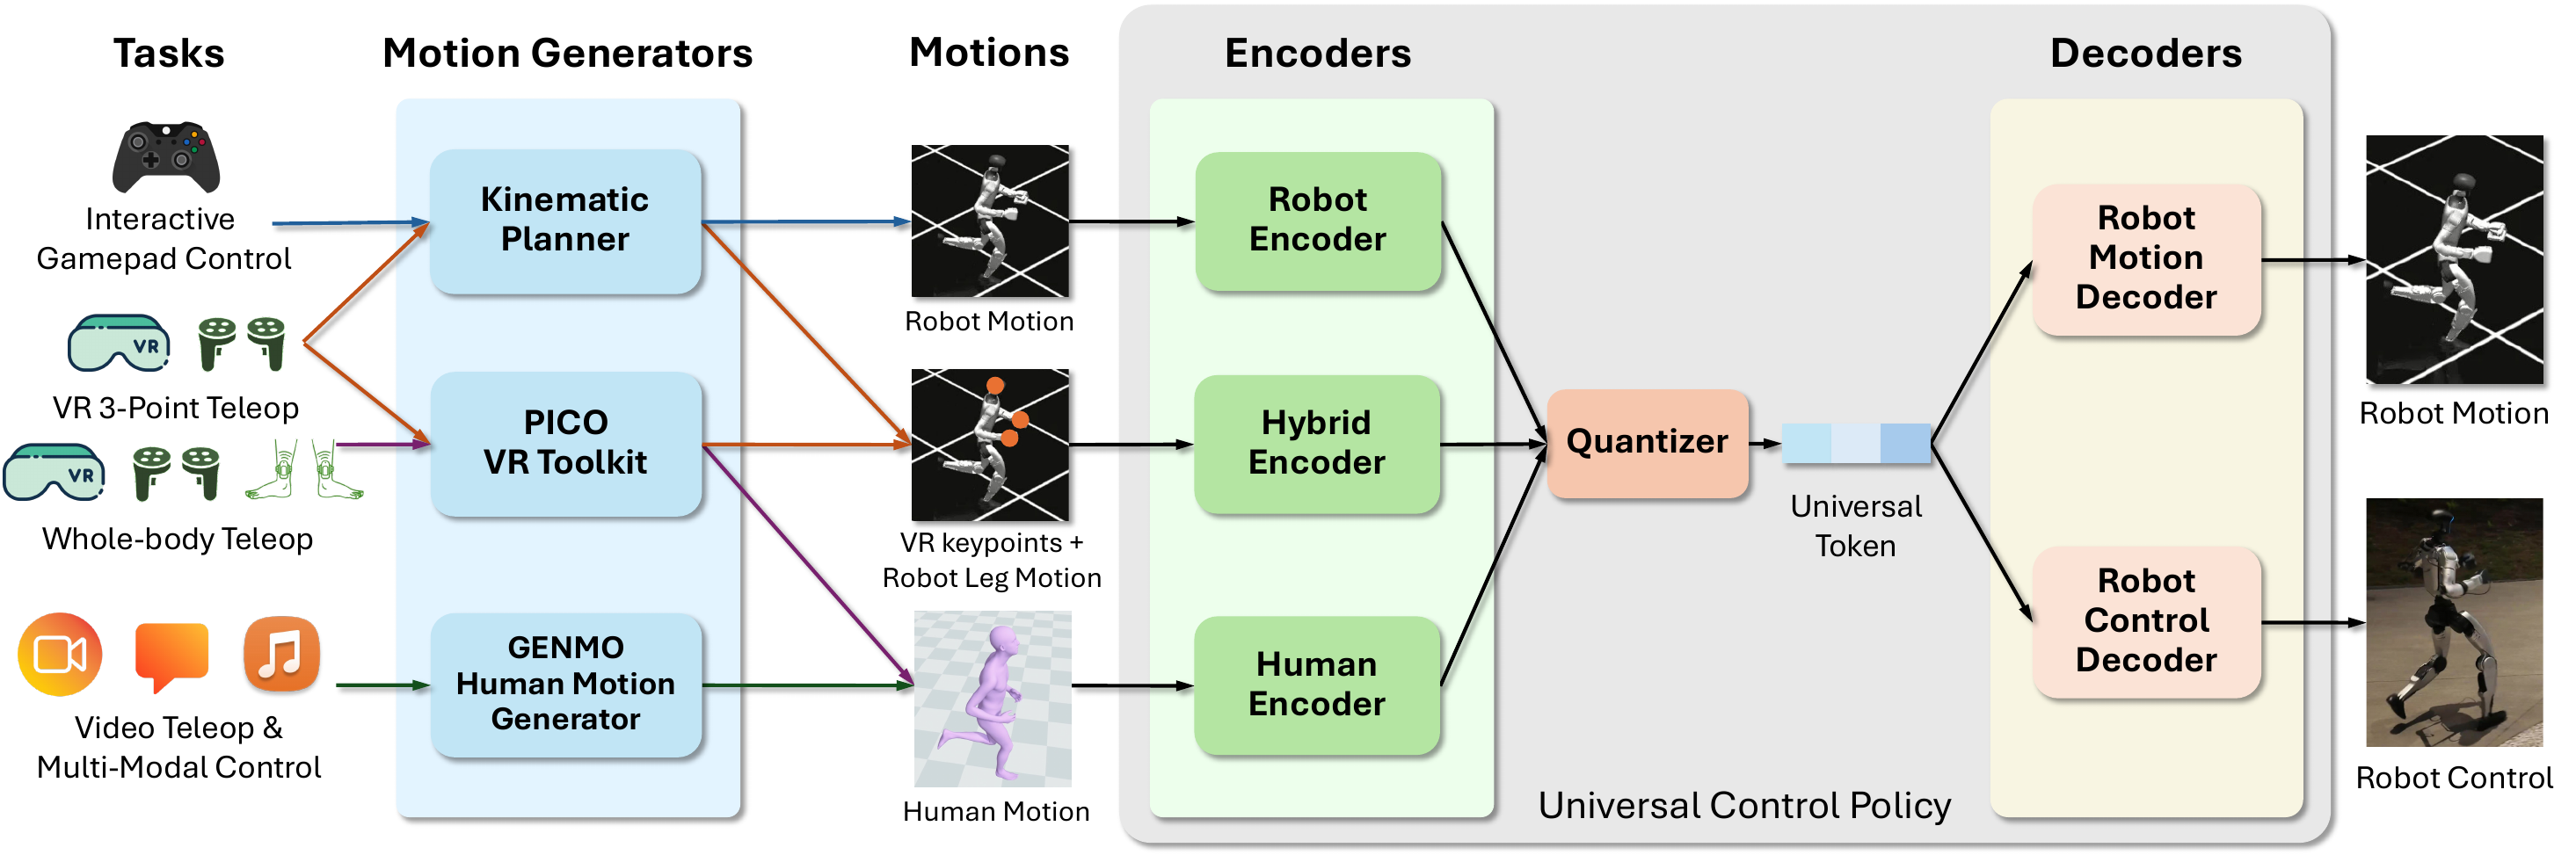
应关注图中 encoder、quantizer 和 control decoder 的分工:不同来源先转为兼容的运动条件,再进入共享表示,最后由控制分支输出动作。它不是把游戏手柄、人体关键点和文本原样拼进一个已训练的跟踪 actor。迁移到新机器人时,需要逐一验证这些接口,而不只是替换末端 PD。
抽象成接口:
其中 表示不同输入模态或条件形式。编码器之后还有 FSQ 有限标量量化,控制分支根据 token 和当前观测产生动作,运动重建分支提供辅助监督。若第 j 个量化坐标有若干有限等级,组合容量为:
量化意味着编码空间中一段连续变化可能映射到同一个 token,而跨越等级边界时 token 会变化。因此接口设计还要考虑编码覆盖和边界行为,不能直接把它等同于连续行为向量或某一电机目标。SONIC:编码、FSQ 与两个解码分支
对于迁移,这会引出两个相互独立的问题。第一,底层策略能否在新机器人的动力学上执行;第二,编码器是否仍能把该机器人的目标映射到合适表示。即使两个模型 token 维度相同,也没有理由认为 token 语义相同。
不能把 SONIC 的规模收益归结成“把 MLP 加宽就够了”。训练数据多样性、交互样本量和表示接口同时影响结果。若数据里几乎没有双手承载与外力撤除,单纯增加自由空间动作帧数不一定改善物体接触中的柔顺交互。
还有一个容易混淆的成本:训练成本和部署成本。21k GPU 小时不代表每次部署都需要同等硬件;反过来,checkpoint 能实时运行也不代表能以同样低成本重训到另一种机器人。
6. BFM-Zero:latent 对应的是任务目标
BFM-Zero 采用 Forward–Backward 表示与在线 off-policy 训练,将目标、动作和奖励连接到共享 latent;实际机器人 actor 使用历史观测,训练时使用更充分的信息,并加入物理约束相关的辅助奖励。它的“无监督”不等于完全没有动作数据、先验或辅助代价。BFM-Zero 论文
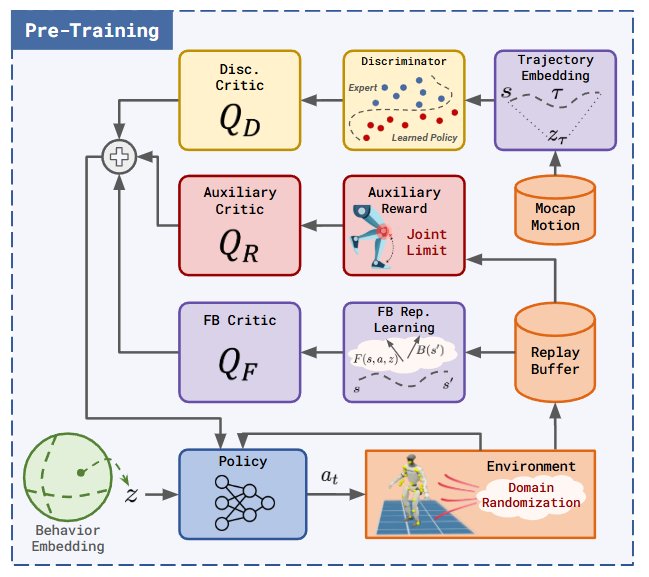
图中的 FB critic、辅助 critic 与动作先验相关分支不是三个同义模块。FB 部分学习可按行为条件查询的价值表示,辅助奖励约束物理执行,动作数据相关分支提供行为先验;环境 transition 则进入 replay。后面的辅助奖励表只对应其中一条分支。
先定义折扣状态访问测度。给定当前状态与动作,之后使用条件策略,访问某个状态区域 X 的累计量为:
FB 的核心近似可写为:
其中, 表示目标状态特征, 与当前状态、动作及条件策略有关。对访问测度按奖励积分,得到 Q:
代入有限秩近似:
项目给出的提示方式包括目标姿态 、未来动作窗口的特征加权和,以及依据 buffer 中状态奖励计算 latent。BFM-Zero 方法说明
奖励提示的一个有用性质来自这个期望的线性性。在固定编码 B 与采样分布、尚未做归一化时,两项任务奖励满足:
因此“向前移动”和“手保持高度”可以先在奖励层组合,再估计行为条件,而不一定先合成一条完整参考轨迹。但组合 latent 不等于把两套动作直接相加;归一化、有限数据覆盖和近似 critic 都会影响执行效果,也不保证组合后的策略满足每一项任务约束。这正是奖励提示路线相对显式跟踪增加的能力与验证成本。
给定 N 个状态样本,奖励提示对应下面的均值估计;最终仍需按模型约定处理 latent 的尺度与归一化:
后式省略历史与特权状态的参数,分别保留 FB 任务价值、动作先验 critic 和物理辅助 critic。辅助奖励表只影响其中的 Q_R 分支,不能代替整个 actor 目标。BFM-Zero:训练目标与奖励提示推导
工程实现中应检查 latent 的归一化和采样约定,不能将上面的概念公式原样替代接口。官方代码分别提供 tracking、goal 和 reward inference,说明“同一个策略”仍需要不同的任务到 latent 的推断过程。BFM-Zero 推断实现入口
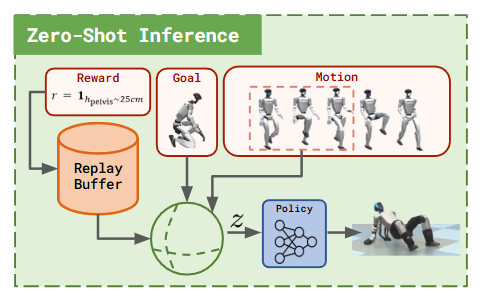
官方推理机制图:BFM-Zero 作者,原图,未修改。
左侧三种输入先得到行为 latent,actor 再结合当前观测产生动作。奖励提示还依赖 buffer 中状态样本;图中的箭头不是“把任意 Python 奖励函数直接接到电机”,也不免除特征覆盖与推断误差。
这与直接给出未来关节参考的区别,可以用一个具体任务理解:如果只要求“向前移动且右手保持某高度”,显式跟踪路线需要先找到满足条件的动作参考;奖励提示路线可以将这些要求组合成 ,再推断 latent。
但公式中的期望依赖采样分布。如果 buffer 很少覆盖所需姿态,或者特征表示不能区分关键接触状态,推断出的 未必能解决任务。有限秩近似、估计误差和策略优化误差都存在,不能把 zero-shot 解释成对任意新奖励保证最优。
对迁移而言,增加两个关节也不是给输出层多接两个神经元:状态特征、历史动作、运动数据和动力学都变了。已有机器人的预训练表示具有参考价值,但它不会自动变成新机器人的已验证控制器。这里应区分同一机器人上的新任务提示与跨机器人迁移;前者的 zero-shot 结果不能直接证明后者也无需训练。
7. 这些 latent 不能仅凭名称类比
SONIC 的共享表示强调统一运动条件入口;BFM-Zero 的 latent 与任务目标及价值表示关联;ProtoMotions 中某个实验是否存在 latent、如何训练它,要由该实验定义。三者都出现向量 ,并不意味着它们优化相同目标。
一个简单鉴别方法是问:修改 的某一方向,预期改变什么?如果答案是改变编码后的运动模式,就应评估动作覆盖与条件重建;如果答案是改变被优化的任务目标,就应评估目标/奖励推断与组合性能。不能只画 latent 插值动画,就宣称拥有任意任务控制能力。
同样,模型支持动作跟踪,不表示它会适度降低夹持力;存在柔顺演示,也不表示它满足可计算的接触力界。这些能力需要对应的观测、训练分布和评估协议。
奖励与目标函数:框架相近,优化对象未必相同
BeyondMimic 与本文 ProtoMotions 实验的环境项分别为“六个跟踪项+三项正则”和“五个跟踪项+两项正则”。后者没有配置 anchor 位置/非期望接触项,动作平滑的数学形式也不同;完整系数分别见基础篇的奖励表与ProtoMotions 奖励表。比较学习算法前,应先对齐这些任务定义。
BFM-Zero 则需要区分 FB 表示学习、动作先验相关目标、物理辅助奖励,以及推理时用于构造 latent 的任务奖励。下面是 BFM-Zero 官方辅助奖励预设中的全部十项非零物理辅助项,不是其所有学习损失,更不是“给定动作逐帧跟踪”的奖励表。官方奖励配置
环境先把权重乘控制周期 dt。基础奖励预设默认关闭课程,而官方训练任务会将其开启;初始 penalty scale=0.10,范围 [0,1],只作用于名单内的项。下面“课程”列对应开启课程后的训练设置;只对列入课程的项使用这一缩放。
点击名称可跳到对应的公式与实现说明,并自动展开。
| 名称 | 配置权重 | 乘惩罚课程 | 作用 |
|---|---|---|---|
penalty_torques |
−0.000001 | 是 | 降低力矩平方和 |
penalty_undesired_contact |
−1 | 是 | 减少不允许的接触 |
penalty_action_rate |
−0.5 | 是 | 抑制策略动作突变 |
penalty_ankle_roll |
−0.5 | 是 | 限制脚踝 roll 偏转 |
penalty_feet_ori |
−0.1 | 是 | 减少触地时的足倾斜 |
feet_heading_alignment |
−0.1 | 否 | 约束脚相对 root 的朝向 |
penalty_slippage |
−1 | 是 | 减少接触脚速度 |
limits_dof_pos |
−10 | 是 | 限制位置越界 |
limits_dof_vel |
−5 | 否 | 限制关节超速 |
limits_torque |
−5 | 是 | 限制接近力矩上限 |
逐项实现
penalty_torques
原始值是所有关节力矩平方和。很小的数值仍可能产生明显贡献,因为力矩带物理尺度且按关节累加。不能把 −1e−6 与有界指数跟踪项的 1.0 直接比较。
1 | raw = torques.square().sum(-1) |
penalty_undesired_contact
运动环境覆盖了基础实现:只要指定身体中任一接触力分量的绝对值大于 1 N,就返回 1,而不是按接触身体个数相加,也不是力范数阈值。
1 | raw = (contact_forces[:, forbidden_ids].abs() > 1).any(dim=(1, 2)).float() |
penalty_action_rate
相邻动作的平方和,没有除控制周期。它约束控制输出,不是 FB 表示损失;动作到 PD 的缩放仍会改变物理影响。
1 | raw = (last_actions - actions).square().sum(-1) |
penalty_ankle_roll
运动环境单独读取左右 ankle roll 角度并平方相加。该项并非跟踪参考脚踝角,而是偏向 roll=0;过强可能限制合法的侧向姿态。
1 | raw = left_ankle_roll.square() + right_ankle_roll.square() |
penalty_feet_ori
将重力方向旋转进各脚坐标系,取水平分量的范数;只在对应脚 z 向接触力 >1 N 时生效。它不是直接罚脚的三个欧拉角。
1 | raw = (foot_gravity_xy.norm(dim=-1) * (foot_force_z > 1)).sum(-1) |
feet_heading_alignment
分别计算左右脚与 root 的 yaw,用 wrap_to_pi 得到最短角差,取绝对值求和。虽然系数为负,此项不在课程惩罚名单,因此不乘该课程系数。
1 | raw = wrap_to_pi(yaw_left - yaw_root).abs() + wrap_to_pi(yaw_right - yaw_root).abs() |
penalty_slippage
实现是接触门控的三维足部线速度范数之和,不是水平速度平方;接触门限使用力范数 >1 N。只凭 slippage 名字不能判定各论文测量的是同一量。
1 | raw = (foot_velocity.norm(dim=-1) * (foot_force.norm(dim=-1) > 1)).sum(-1) |
limits_dof_pos
上下软边界之外的线性距离按关节求和。配置软位置比例为 0.95;软限位课程默认关闭,与奖励惩罚课程是两个独立开关。
1 | raw = ((lower_soft - q).clamp_min(0) + (q - upper_soft).clamp_min(0)).sum(-1) |
limits_dof_vel
超过 0.95 倍速度上限后产生代价,每关节越界量最多计 1 rad/s。这项没有列入当前 reward_penalty_reward_names,所以从开始就使用完整的配置权重。
1 | raw = (qd.abs() - 0.95 * velocity_limit).clamp(0, 1).sum(-1) |
limits_torque
当软力矩限位课程关闭时,源码对超过 0.95 倍上限的部分取正部并求和,没有每关节 max=1 裁剪;不能与速度项写成完全相同的函数。
1 | raw = (torques.abs() - 0.95 * torque_limit).clamp_min(0).sum(-1) |
为什么十项辅助代价还不是 BFM 的“任务”
辅助 critic 让动作保持在机器人可以承受的范围内,但“向前走还是向后走”由行为条件与任务提示决定。不能把十项物理代价求和后称为完整的 FB 目标,也不能把推理时用户写的奖励当成每次都要重新训练 actor 的奖励。表示学习把任务到 latent 的映射提前准备好,推理再通过状态样本与任务评分选择条件。
这与 ProtoMotions 的差异是工程取舍:当前显式参考策略的输入、误差和 PD 契约更容易逐项审计;BFM 路线增加表示覆盖与 latent 推断这层需要验证的对象。本文没有对 BFM-Zero、SONIC 或 TWIST2 做目标机器人的移植或同机复现,因此不把它们的官方配置写成“当前适配后的参数”,也不虚构一套统一奖励权重。对 SONIC 和 TWIST2 的比较限定在官方说明的系统接口;它们的不同训练阶段应各自绑定配置后再做数值对照。
8. 为什么当前选择 ProtoMotions,而不是直接跳到最大模型
选择依据是当前要解决的工程问题:在目标机器人上建立可解释、可训练、可导出并能继续扩展的全身控制器。已有机器人模型和重定向数据时,显式跟踪路线能直接验证关节映射、动力学、PD、动作尺度和时间契约,再逐步扩大数据与任务范围。
这一判断不是性能排名。若目标变为“已有支持平台上快速接入多种动作输入”,SONIC 的通用入口值得优先评估;若核心研究是“不为每个目标重训策略,通过奖励组合控制行为”,BFM-Zero 更直接对应问题。若目标是高质量采集闭环,则需要系统级路线。
真正应该复用的是各自解决问题的机制:从 BeyondMimic 建立跟踪基线,在 ProtoMotions 中明确实验和部署接口,借鉴 SONIC 对数据覆盖与控制表示的处理,并用 BFM-Zero 检验任务提示是否能减少对显式轨迹的依赖。
9. 对比实验需要统一哪些条件
比较需固定机器人、动作测试集、接触条件、控制频率和允许使用的传感信息,并分别报告以下三组结果。
第一组是闭环执行:完整动作成功率、局部与全局位置误差、滑脚速度、力矩饱和比例。位置误差可写为:
若做 root 对齐或朝向对齐,必须注明。每帧对齐会移除漂移信息,因此局部误差小不能替代全局执行正确。
第二组是接口能力:完整轨迹、稀疏关键点、单目标和奖励提示分别怎么输入,是否需要额外规划器,是否发生任务相关微调。把“额外训练了上层”与“低层零样本执行”同时写清楚。
第三组是资源与迁移:训练交互步数、GPU 小时、推理时延分布、导出后的依赖,以及新增机器人必须重做哪些数据和模块。公开数据与自采数据应分开统计,不能只报告网络参数量。
本文给出基于接口与训练目标的选型分析,尚未完成同机器人、同动作测试集的统一性能基准。
一个可检验的选型结论应当能够被实验推翻:如果在相同预算与接口条件下,另一条路线显著降低适配成本并提高目标任务成功率,就应调整选择。选择 ProtoMotions 的理由是当前问题与其模块化跟踪流程匹配,而不是认为框架名称本身意味着更强控制能力。