基于 ProtoMotions 的全身控制器训练与部署
训练中的动作跟踪表现由整条控制链共同决定:参考在哪个时刻采样、观测如何表示、动作怎样变成关节目标,以及执行器怎样施加力矩。只保存网络权重,会遗漏足以改变机器人行为的控制参数。
ProtoMotions 是构建和训练物理角色控制器的框架,不能把框架名称当成一个固定策略的名称。本文以一套 31 自由度全身跟踪控制器为例:它使用动作跟踪目标、非对称 actor–critic 和局部一致性正则。其他实验的观测和动作变换可能不同。ProtoMotions 官方实现
1. 从参考采样到执行器:一轮控制怎样完成
未来 1 / 2 / 4 / 8 步
上一时刻的关节目标
输出 joint_pos_targets
Anchor、四元数约定
历史排列与动作语义
PD 与力矩限制
图 1:参考、观测和网络输出需在训练与部署中保持相同含义;机器人映射、时间约定和执行器参数与模型一起保存。
可将整个系统写为:
其中, 是动作采样器, 是观测构造, 是历史, 是动作变换, 包含执行器与接触动力学。训练 loss 降低,只能说明这五个接口在训练环境下共同产生了某种行为。
因此迁移要逐项验证:动作是否表达同一个姿态,观测是否使用同一个 frame,网络输出是否经过同一次变换,执行器是否实现同一套位置目标和增益。
2. 动作数据不只是一个关节角数组
一段可用于全身跟踪的动作通常还需要 root 位姿、身体位姿和速度。即使两个文件都是 (T, 31),关节顺序、轴方向和默认姿态不同,也不能互换。
重采样首先要保住物理时间
原动作有 帧、频率 ,若第一帧时间为零,最后一帧的时间是:
以 30 Hz、450 帧转换到 50 Hz 为例,持续时间是 s,按不超过终点的规则采样得到:
直接把帧数乘 得到 750,会混淆采样区间和采样点。不同库可能采用保留精确终点的策略;必须把时间戳约定写入转换器,而不是凭帧数猜时长。
关节角要先处理周期跳变再插值;姿态使用合适的旋转插值;速度应由重采样后的轨迹和实际时间间隔计算。把 50 Hz 的角度差除以 30 Hz 的时间间隔,会将速度缩小为正确值的 0.6 倍,critic、阻尼相关观测和动作相位都会受影响。
Anchor 是运动学定义,不是随意起的名字
该控制器选择腰部俯仰关节之后的躯干刚体作为 anchor。腰部关节运动时,它与浮动基座姿态不同。部署中若只有 root IMU,应通过关节状态与运动学关系得到目标 anchor 姿态;直接用 root 四元数填入 anchor 字段会引入与腰部动作相关的系统误差。
默认姿态也需要和模型一起固定。该配置肘关节默认角是 -0.5 rad;另一套动作跟踪模型使用 +0.4 rad。这个差异要求先检查关节轴与零位定义,不能仅凭正负号认定谁错了,更不能把一个策略的默认角直接塞给另一个模型。
3. 多个时钟如何保持一致
若物理频率为 、动作保持 个物理步,则:
这套机器人配置的 Isaac Lab 与 Newton 路径均是 200 Hz、decimation 4,得到 50 Hz 策略;Isaac Gym 路径是 100 Hz、decimation 2,并另有物理子步。子步改善积分分辨率,不等于策略进行了更多次观测和决策。
future_steps=[1,2,4,8] 在 50 Hz 下分别指向未来 20、40、80、160 ms。如果只把策略改成 100 Hz 而不改这个列表,前瞻时间就缩短一半,模型条件的含义发生变化。
部署参数中的 1000 Hz 发布率也不能解释成 1000 Hz 策略。发布线程可以多次发送同一个目标;推理周期应服从模型导出的 control_dt。应分别记录采样、推理完成和命令发送时间戳,统计实际延迟及抖动。
控制频率也进入学习目标。若只讨论保持相同物理时间尺度的奖励折扣,控制步长改变后应满足:
例如从 50 Hz 改成 100 Hz,原 gamma=0.99 对应的新值约为 0.99499;若仍用 0.99,同样一秒后的奖励会受到更强折扣。这只是折扣时间尺度的换算,不代表改一个 gamma 就完成了频率迁移:前瞻参考、动作历史、奖励汇总、GAE 和执行器更新仍需分别对齐。
未来 1 / 2 / 4 / 8 步
上一时刻的关节目标
训练时采样,部署时取均值
S = 力矩上限 / Kp
比较两次输出的均值
λ = 1,加入 Actor 损失
4 层 × 1024 → 价值 V
更新 Actor 与 Critic
机制图:依据本文的跟踪控制器与局部一致性正则绘制;这是一种具体的训练结构,不代表 ProtoMotions 全部实验的统一结构。
上方是执行闭环。训练分支中,干净观测通过同一个 actor,为 L2C2 提供配对输出;critic 的特权状态参与优势估计,不应在导出时变成 actor 的隐含输入。七项环境回报与 L2C2 分属环境和优化器两层,所以分别检查 combine_rewards 和 actor loss 才能看全目标函数。
4. Actor 为什么少看一些状态,critic 却多看
这套 actor 使用带噪声的 reduced coordinates、多个未来参考和上一时刻处理后的动作。配置关闭 root 高度、root 线速度观测和目标 XY 偏移;critic 使用干净的身体坐标与更完整的参考信息。
这样做的工程目的,是减少部署 actor 对难以稳定获得的世界位置、速度信息的依赖。它不是宣称这些状态没用,而是把“训练时能获得”和“部署时能可靠测到”分开。
critic 的特权信息帮助估计价值,不应经过观测拼接错误泄露进 actor。导出时应核对 actor 输入键,而不只是检查整个训练模型的输入字典。
这里还有一个容易忽略的历史量:previous_actions_factory(..., processed=True) 保存的是处理后的关节目标,不是原始高斯动作。部署端应回填相同语义;如果回填了缩放前的 ,网络会看到分布不同的历史。
5. 动作缩放:注释中的 0.25 与实际的 1.0
这套动作函数执行:
bm_pd_action 的说明文字提到 ,但创建该实验动作配置的 make_bm_pd_action_config 实际计算:
函数直接使用传入的 scale,没有额外 tanh 或 clamp。下面是该配置工厂得到的值,而不是根据注释推测的值。
| 关节组 | (N·m/rad) | 力矩上限(N·m) | 实际 (rad/action) | 若采用 0.25 系数 |
|---|---|---|---|---|
| 髋、膝 | 250 | 140 | 0.560 | 0.140 |
| 踝 | 80 | 42 | 0.525 | 0.13125 |
| 腰 | 150 | 42 | 0.280 | 0.070 |
| 肩、肘 | 60 | 42 | 0.700 | 0.175 |
| 腕、头 | 25 | 19 | 0.760 | 0.190 |
这不意味着 时实际电机总会达到最大力矩。在 、速度为零、显式比例控制且没有其他项的简化条件下,;实际力矩还取决于当前位置、阻尼、求解器及饱和。
如果只在部署时“修正”为注释中的 0.25,目标偏移将缩小四倍,等于换了动作接口。这种改动应作为重新训练或重新评估的控制配置,不能作为不影响行为的文字修正。
也不能因为原始动作无界,就认为关节目标一定合法。需要记录动作分位数、目标超限比例和实际力矩饱和比例,确认训练中的限制机制与部署保护一致。
6. L2C2 实现究竟惩罚什么
这个实验构造 clean/noisy 成对观测。令批大小为 B、动作维度为 n,配对观测中共有 N 个标量元素。代码先分别计算整批元素的均方差:
集合 P 只包含指定的 clean/noisy 观测对;共享历史动作没有对应扰动,不计入分母。分母在梯度图中被 detach,配置权重为 1。整批的比值也不等于逐样本比值的平均:后者会让扰动极小的个别样本获得很大权重。它是采样扰动上的局部敏感度约束,不能解释为对所有状态成立的全局 Lipschitz 证明。
分母包含位置、角度、速度等不同单位的观测差时,数值会受到特征尺度影响。因此观测归一化、噪声幅度和正则权重必须一起解释。该实现用输入张量差构造分母,不能未经检查便称作“归一化空间中的距离”。
更进一步,网络动作平滑不等于力矩平滑。在固定状态的局部近似下:
同样的 ,在不同动作缩放下会产生不同的力矩变化。若目标是抑制真实机械抖动,评估还应包含处理后的目标速度和实际力矩变化,而不只是 l2c2_loss。
7. 奖励、初始化和扰动组成同一个训练任务
该实验使用全局 anchor 方向、相对身体位置和方向、身体线速度与角速度等跟踪项,另有动作变化和关节限位惩罚。相对身体位置项权重 1、sigma 0.3,方向项权重 1、sigma 0.4,anchor 方向权重 0.5。anchor 高度相对参考误差阈值为 0.25 m,不能误读为绝对离地高度只有 0.25 m 才终止。
配置不在每步把参考重新对齐机器人位置。这一点影响策略如何处理累计漂移:若评估时偷偷每帧对齐,得到的跟踪误差会掩盖世界系偏移。
位置、角速度、关节观测噪声与 reset 噪声也不是同一件事。前者训练对测量不确定性的适应,后者扩大初始状态分布;随机外力训练恢复行为。三种机制可以互补,不能用“已经加了 domain randomization”省略具体幅度、频率和分布。
这套配置是 6 层、每层 1024 单元的 actor MLP,critic 为 4 层 1024。模型足够大并不能自动解释泛化。应固定架构比较动作覆盖,再固定数据比较架构,否则数据与容量效应无法区分。
当前实验启用的项,而不是框架能力清单
下表对应本文采用的动作跟踪+局部一致性正则方案。combine_rewards 对七个环境项直接按权重相加,这条汇总路径没有额外乘 dt;因此相同的 1.0 与 Isaac Lab/Holosoma 的 1.0 不具有相同单步尺度。五个指数项全为 1、两项代价为 0 时,原始环境奖励为 4.5。该实验还设置 normalize_rewards=False。
把五个跟踪核分别记为 anchor 方向、身体位置、身体方向、线速度和角速度奖励,单步回报为:
PPO 使用这个 R 计算 GAE 和 return,actor 损失再单独加入一致性项:
当前 MLP 实验启用可学习标准差,默认熵系数为 0.005,PPO 裁剪范围为 0.2;bounds 项按配置开关加入,model 项取决于网络是否提供附加损失。它们都不进入环境奖励。critic 另有自己的回归更新,当前启用价值裁剪:
这里的 return 是归一化优势之前得到的训练目标。环境中的动作变化代价约束相邻时刻的关节目标,L2C2 约束同一状态附近的输入扰动响应,价值损失约束 critic;三者的自变量、单位和梯度路径都不同。
点击名称可跳到对应的公式与实现说明,并自动展开。
| 名称 | 系数 | 尺度/定义 | 作用 |
|---|---|---|---|
global_anchor_ori |
0.5 | σ = 0.4 rad | 跟住 anchor 朝向 |
relative_body_pos |
1 | std = 0.3 m | 保留身体相对几何 |
relative_body_ori |
1 | std = 0.4 rad | 保留各身体姿态 |
body_lin_vel |
1 | std = 1 m/s | 匹配平移速度 |
body_ang_vel |
1 | std = 3.14 rad/s | 匹配转动速度 |
action_rate |
−0.1 | processed action 的 L2 范数 | 限制相邻关节目标变化 |
limits_dof_pos |
−10 | 机器人配置的上下界 | 限制越界 |
L2C2 |
λ = 1 | 优化器正则;非环境奖励 | 限制噪声附近输出变化 |
逐项实现
global_anchor_ori
由 global_anchor_ori_rew_factory 绑定 compute_global_anchor_ori_rew,使用最短四元数旋转误差;anchor 从机器人配置解析。当前实验没有同时启用 anchor 位置奖励,因此不能把 BeyondMimic 的 0.5 位置项补进来。
1 | angle = quat_error_magnitude(q_ref, q_actual) |
relative_body_pos
compute_relative_body_pos_rew 比较经过 anchor/yaw 对齐的参考身体位置与实际位置:先对 xyz 求平方和,再对身体取均值,最后求一次 exp。它不是逐身体 exp 后求平均。与 BeyondMimic 对齐时保留参考 anchor 高度不同,这个核对实际/参考各自减去完整 xyz anchor 位置,再各自去 yaw,因此整体高度偏差也被相对化;当前配置靠 anchor 高度终止等机制补充约束。身体列表改变后,每个部位在均值中的占比也会改变。 工厂把当前状态、参考状态和身体索引绑定到纯 tensor kernel;该实验未额外传入区域权重,不能把其他实验的手脚加权自动套用。
1 | err2 = (p_body_aligned - p_body).square().sum(-1) |
relative_body_ori
compute_relative_body_ori_rew 对每个身体计算最短旋转角,平方后在身体维度平均,再用 0.4 rad 核。相对目标的构造与位置项共享参考约定,不能把局部和世界四元数混用。 工厂把当前状态、参考状态和身体索引绑定到纯 tensor kernel;该实验未额外传入区域权重,不能把其他实验的手脚加权自动套用。
1 | angle = quat_error_magnitude(q_body_aligned, q_body) |
body_lin_vel
compute_global_body_lin_vel_rew 比较世界系身体线速度,三轴平方和后对身体平均;1 m/s 是误差尺度。位置很接近但身体仍在快速冲过目标时,这项会降低奖励。 工厂把当前状态、参考状态和身体索引绑定到纯 tensor kernel;该实验未额外传入区域权重,不能把其他实验的手脚加权自动套用。
1 | err2 = (v_ref_w - v_w).square().sum(-1) |
body_ang_vel
compute_global_body_ang_vel_rew 比较世界系身体角速度。3.14 rad/s 是指数核尺度,不是机器人最大允许角速度。它补充姿态项,但不能替代力矩限制。 工厂把当前状态、参考状态和身体索引绑定到纯 tensor kernel;该实验未额外传入区域权重,不能把其他实验的手脚加权自动套用。
1 | err2 = (omega_ref_w - omega_w).square().sum(-1) |
action_rate
action_smoothness_factory 调用 compute_action_smoothness → delta_norm。源码执行 torch.norm(diff, dim=-1),不是平方和!本实验 processed action 是完成动作映射后的关节目标,因此作用尺度还受每个关节 action scale 影响。把它与 BeyondMimic 的原始动作平方和共用 −0.1,不代表两者正则强度相同。
1 | cost = torch.linalg.vector_norm(q_target - q_target_prev, dim=-1) |
limits_dof_pos
compute_soft_pos_limit_rew 名字虽然带 soft,实际边界由 kinematic_info.dof_limits_lower/upper 传入。核函数将线性越界距离求和;当前实验没有传入可选的 max_violation,所以不能宣称惩罚已经封顶。不要把 Holosoma 的 0.98 范围收缩参数套到这里。
1 | cost = ((lower_soft - q).clamp_min(0) |
L2C2
这里列出是为了交代总优化目标,不能与上面七项加成单步奖励。当前实现使用干净/带噪观测的 actor 均值差,除以输入差的平方均值及稳定项;分子和分母各自在整批元素上求均值后取比值,不能改成逐样本比值再平均;分母 detach,未配对的历史动作不计入分母。输入使用哪一级归一化张量会改变这一比值,详见第 6 节。它不是动作率惩罚,也不直接证明整个闭环满足 Lipschitz 上界。
1 | # paired_diffs 只含配置指定的 clean/noisy 观测对 |
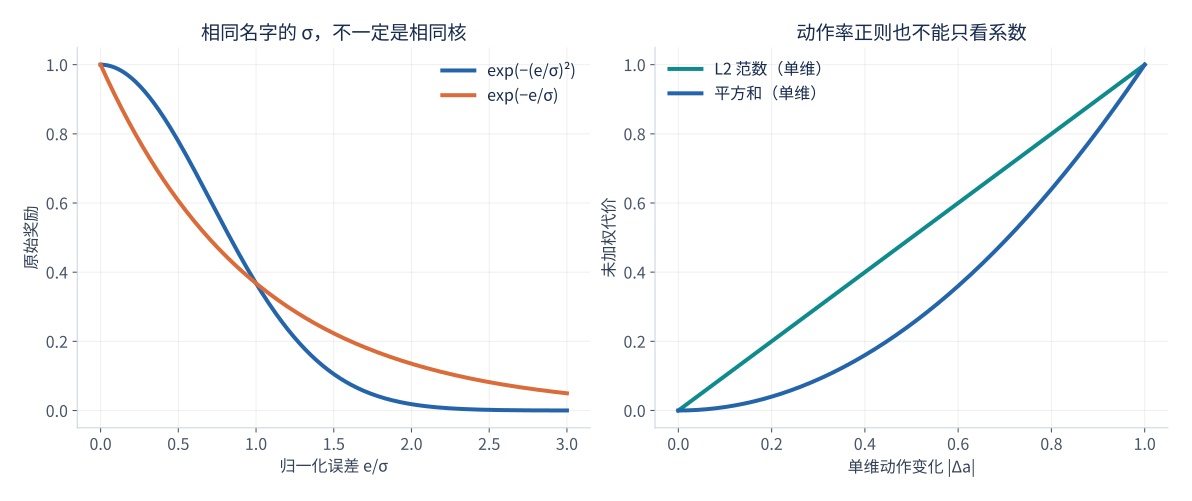
解析图:按公式计算,无训练或实机测量。左图比较归一化误差下的两类指数核,右图用单维变化展示范数与平方代价的差异;多关节时还需考虑聚合方式和动作单位。
例如同一单位下单维动作变化 0.1,L2 范数为 0.1、平方和为 0.01,相差十倍;变化达到 1 时才相同。正则项名称、系数相同,而原始量不同,训练效果当然不能直接等价。
相对原生方案,改动发生在何处
这套跟踪方案复用了 ProtoMotions 的组件机制,并选择 BeyondMimic 风格的参考对齐与跟踪项;它不是 ProtoMotions 所有 mimic 实验的统一默认值。与本文 BeyondMimic 基线相比,当前配置未启用 anchor 位置和非期望接触两项,动作平滑从原始动作平方和换成 processed action 的范数,并加入 L2C2。接触惩罚函数存在于框架中,不代表这份实验调用了它。
机器人适配进一步修改 31 自由度的关节映射、默认姿态、PD 与动作尺度。运行代码采用 effort / stiffness,而部分说明仍写 0.25 * effort / stiffness;以上一节算出的肩部 0.7 rad/action 为例,这个差异会把未饱和的动作到力矩增益放大四倍。导出协议必须记录运行值。
8. 策略导出与部署接口的一致性
部署端读取与 ONNX 配套的控制参数,验证自由度数、anchor、关节顺序、控制周期与参考步长,并检查输入输出形状及有限值。它拒绝需要当前世界位置等部署端无法满足的输入契约。
尤其要确认 ONNX 输出名 joint_pos_targets:它已经表示最终关节位置目标。不能再执行一次 。若输出是原始动作,则必须执行一次;这两种模型必须用显式元数据区分。
用一条固定测试向量检查接口,比只检查张量维度更有价值:
1 | # 教学示意:训练端和部署端使用同一个冻结状态与参考 |
测试向量至少包括站姿、腰部旋转、非零关节速度和一组非平凡四元数。全零输入可能无法暴露轴顺序和符号错误。
动作滤波同样属于契约。该 tracker 默认不启用额外动作滤波,EMA 系数为 1、加速度上限为空。临时加很强的低通虽然可能让曲线好看,也会增加相位延迟,应重新评估跟踪和失稳边界。
9. 跟踪评估与关键消融
先报告固定动作集合上的连续跟踪成功率、局部/全局身体位置误差、滑脚速度、力矩饱和比例和推理延迟。再将动作按接触切换、腰部大旋转、快速摆臂、单脚支撑分层,检查最差类别,而不是只展示平均值。
建议的最小消融是:动作尺度系数 0.25 与 1、L2C2 开关、不同参考前瞻长度。每组均从相同协议训练与评估,不能把一个现成 checkpoint 的 scale 临时改掉来代替公平对比。
本文报告控制器结构与配置计算,尚未提供上述消融的训练结果或实测延迟曲线。
在这个基础上,再引入更多动作、masked conditioning 或更复杂策略结构,才能辨认性能收益来自哪里。ProtoMotions 的价值是让这些组件可以在明确接口上迭代;一套没有经过接口验证的大模型,仍可能只是更昂贵的错误控制器。